課題:欠品と過剰在庫、そして「そのままでは使えない」販売データ
A社は小売チェーンで、導入前は欠品と過剰在庫の両方による損失を抱えていました。一般に、欠品は売れたはずの売上を逃し、過剰在庫は保管の負担や売れ残りのリスクを増やします。どちらか一方を抑えようとするともう一方が悪化しやすいため、需要の見通しを数字で持てるかどうかが改善の出発点になります。
そこでバイナリテックジャパンは、A社に蓄積された4年分の日次販売データを学習に使う方針で分析を始めました。ところが、データは連続しておらず、ところどころ日付が途切れていたうえ、生データのままでは周期もはっきり読み取れませんでした。時系列の予測モデルは通常、等間隔に並んだデータと繰り返し現れるパターンを手がかりにするため、整えないまま投入すると、途切れや雑音まで需要の動きとして覚えてしまいます。
体制と役割:バイナリテックジャパンが担当した範囲
本案件は、バイナリテックジャパンがA社と契約し、プロジェクトの責任を負って実施しました。A社との窓口もバイナリテックジャパンが務め、担当範囲は次のとおりです。
- 業務分析
- データ処理(欠損の判定と補完、特徴量の作成、周期の分析)
- 予測モデルの構築と選定
- A社のWMSへの組み込み
- 定期的な再学習
バイナリテックジャパンは、既存システム(WMS/TMS/MES/ERP)を活かしたまま段階的にAIを導入することを基本の考え方にしています。本案件でもこの考え方に沿って、予測結果はA社が使っているWMSに組み込む形をとりました。
データの欠損と周期をどう扱ったか:前処理の4つの手順
本案件の成否を大きく左右したのが、データの前処理です。バイナリテックジャパンは、欠損の種類を見分けて種類ごとに対処し、その系列からラグと移動平均の特徴量を作り、周期を確かめて季節性を分離してから予測する、という順番で処理を組み立てました。全体の流れは次の図のとおりです。
- 日次販売データ(4年分) → 欠損の種類を判定
- 欠損の種類を判定 → 祝日の休業:祝日特徴量
- 欠損の種類を判定 → 悪天候:天候特徴量
- 欠損の種類を判定 → 記録漏れ:補間
- 祝日の休業:祝日特徴量 → 欠損に対処した系列
- 悪天候:天候特徴量 → 欠損に対処した系列
- 記録漏れ:補間 → 欠損に対処した系列
- 欠損に対処した系列 → ラグ・移動平均の特徴量を作成
- ラグ・移動平均の特徴量を作成 → フーリエ変換で周期を確認
- フーリエ変換で周期を確認 → STLで季節成分を分離(周期365日)
- STLで季節成分を分離(周期365日) → 季節調整済み系列と特徴量をARIMAで予測
- 季節調整済み系列と特徴量をARIMAで予測 → 季節成分を再結合
- 季節成分を再結合 → 需要予測値
手順1:欠損を「祝日の休業」「悪天候」「記録漏れ」に分ける
A社の日次販売データの途切れを調べると、原因は三つに分かれました。祝日に店舗が休業した日、悪天候の日、そして販売の記録漏れです。祝日と悪天候による途切れは2〜3日程度、記録漏れは平均で3〜5日連続しており、欠損した日数は全体の約5%でした。
欠損率だけでなく、欠損の原因を区別する必要がありました。三つはいずれも販売データが残っていない日ですが、意味が異なります。祝日の休業と悪天候の日は、データがない理由が分かっている日です。これに対して記録漏れは、売上があったはずなのに数字だけが残っていない日です。一般に、理由の分かっている欠損と記録の不備を同じように補間すると、実際には起きなかった売上を系列に書き込むことになり、本当の需要の動きと記録の不備が一つの系列の中で混ざってしまいます。
実際、本案件の初期には欠損を機械的に補間してから予測モデルの学習に使う方法を試しましたが、予測精度は非常に低い結果にとどまりました。そこでバイナリテックジャパンは、欠損の種類ごとに扱いを変える方針に切り替え、学習データに特徴量を加えました。祝日の休業には、日本の祝日を表す特徴量を加えました。悪天候については、A社が事業を行う地域の天候データを抽出し、その中から悪天候の日を絞り込んで特徴量にしました。補間の対象にしたのは記録漏れの日だけです。休業や悪天候の日を通常の売上で埋めず、祝日や悪天候の日であることを特徴量として明示しておけば、一般にモデルはそうした日の前後の動きを、記録の不備とは区別して学習できます。
判断の対応関係を表にまとめます。理由の列は一般的な考え方として整理したもので、自社のデータに当てはめる際の目安になります。
| 欠損の種類 | 規模(本案件) | 対処 | 理由(一般的な考え方) |
|---|---|---|---|
| 祝日の休業 | 2〜3日程度の途切れ | 日本の祝日を特徴量として追加 | 売上がないのは実際の休業によるもので、補間すると存在しない売上を作ってしまう |
| 悪天候 | 2〜3日程度の途切れ | 地域の天候データから悪天候の日を抽出し特徴量化 | データがない理由が分かっているため、通常の売上で補間せず、悪天候の日であることを特徴量で示す |
| 記録漏れ | 平均3〜5日連続 | 補間で値を埋める | 販売はあったのに記録だけが欠けているため、前後から推定して埋めるのが妥当 |
手順2:ラグと移動平均で直近の動きを特徴量にする
欠損への対処を終えた系列から、バイナリテックジャパンは基本の特徴量を作りました。ラグはLag 7、Lag 14、Lag 21、Lag 28の4つで、いずれも1〜4週前の同じ曜日の実績を参照します。移動平均にはMA 7とMA 28、つまり7日間と28日間の移動平均を使いました。日次の販売データは一般に曜日で動きが変わるため、7日単位のラグで同じ曜日どうしを比べ、移動平均で日々のばらつきをならして水準の変化をつかみます。
本案件では、記録漏れの補完にも、時間のラグや平均を使う手法を用いています。ただし補完と特徴量は役割が別で、一般には補完を先に済ませてから特徴量を計算します。欠けた日を含んだままラグや移動平均を計算すると、特徴量そのものがゆがんでしまうためです。
手順3:フーリエ変換とSTLで周期を確かめる
周期を確かめるため、バイナリテックジャパンはフーリエ変換でデータに含まれる周期を調べました。フーリエ変換は、時系列をさまざまな周期の波の重ね合わせとして捉え、どの周期の波が強く含まれているかを調べる手法です。一方のSTL(Seasonal and Trend decomposition using Loess)は、時系列をトレンド、季節成分、残差に分ける手法で、季節の周期をあらかじめ指定して使います。指定した周期が実際の繰り返しと合っていなければ、一般に季節の動きがトレンドや残差に紛れ込んでしまうため、本案件では先にフーリエ変換で周期を確かめてからSTLの周期を設定しました。
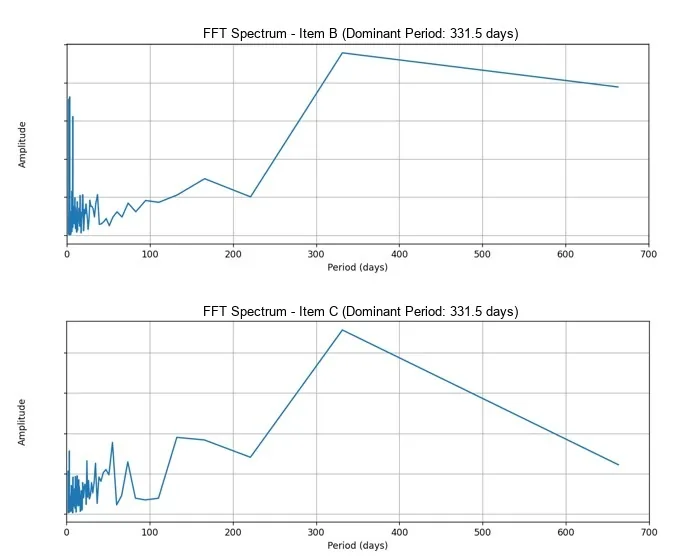
この図は、A社の2つの商品(図中のItem B、Item C)の販売データにフーリエ変換をかけた結果で、横軸が周期(日)、縦軸が振幅です(振幅の数値は匿名化のため非表示)。どちらの商品も最も大きなピークは331.5日に現れ、50日より短い周期の側にも小さなピークが多数見られます。この図は説明のために4年分のデータから約663日分を切り出して計算したもので、検出できる周期は系列の長さを整数で割った飛び飛びの値(約663日、331.5日、221日…)になります。年周期の365日にちょうど当たる候補はないため、年周期は最も近い331.5日のピークとして現れており、本案件ではこれを1年(365日)の季節周期と判断しました。
図はあくまで一部期間の例示です。STLの周期を365日に設定した根拠は、本案件のフーリエ変換の分析で1年周期が確認され、想定外の周期が見つからなかったことにあります。一般に長い周期ほど候補の間隔が粗くなるため、年単位の周期を調べるときは、ピークの位置を候補値の刻みと照らし合わせて読む必要があります。
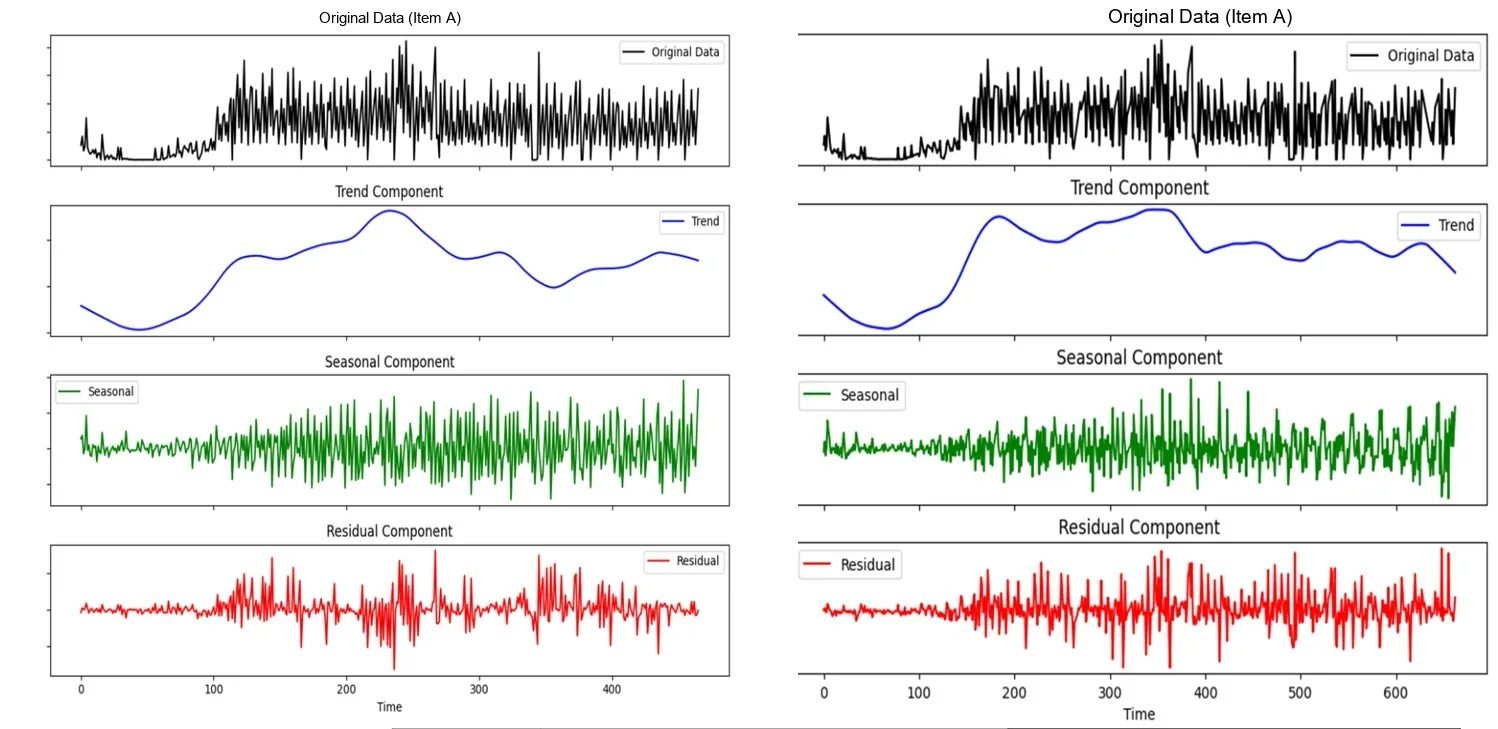
この図は、A社の別の商品(図中のItem A)の日次販売データをSTLで分解したもので、上から原系列、トレンド、季節成分、残差を並べています(縦軸の数値は販売規模が分からないよう非表示)。原系列には、期間の初めに販売量がほぼゼロに近い低い水準の区間があり、その後に水準が上がって日々の上下が大きくなっています。トレンドはこの水準の変化を滑らかな曲線として捉え、季節成分と残差には日々の細かい上下が分かれて現れています。原系列だけでは読み取りにくい水準の変化と細かな変動を、別々の成分として扱えるようになるのがSTLの利点です。
手順4:季節性を外して予測し、最後に戻す
STLで分解したあとは、季節成分を取り除いた系列を予測し、予測値に季節成分を足し戻す手順をとりました。一般に、ARIMAのような時系列モデルは、日次データで365日のような長い季節周期をモデルの中で直接表現するのが得意ではなく、組み込もうとすると推定すべき要素が増えて計算も重くなりがちです。季節性を先に外しておけば、モデルはトレンドと短期の変動の予測に集中でき、季節性はSTLで推定した形のまま戻せます。前処理の前後で変わった点は次のとおりです。
| 観点 | 処理前 | 処理後 |
|---|---|---|
| 欠損 | 祝日の休業・悪天候・記録漏れが区別されずに混在(全体の約5%) | 祝日と悪天候は特徴量として明示し、記録漏れの日だけを補間 |
| 周期 | 周期が読み取りにくい | フーリエ変換で1年周期を確認し、STL(周期365日)で季節成分を分離 |
| 予測の対象 | 季節性を含んだ販売実績そのもの | 季節成分を除いた系列(予測後に季節成分を再結合) |
予測モデルの選定:ARIMA・Prophet・DeepAR+を比べた理由
前処理を終えたデータで、バイナリテックジャパンはARIMA、Prophet、DeepAR+の3つのモデルを比較しました。直近3か月より前のデータで学習し、直近3か月のデータをテストに充てました。時系列の予測では、学習に使っていない直近の期間をテストに残すことで、実際に未来を予測する場面に近い条件で精度を測れます。データをランダムに分けると、テスト期間の前後の情報が学習に入り込み、精度を実際より高く見積もるおそれがあります。
- 4年分の日次販売データ → 学習:直近3か月より前のデータ
- 4年分の日次販売データ → テスト:直近3か月のデータ
- 学習:直近3か月より前のデータ → ARIMA・Prophet・DeepAR+を学習
- ARIMA・Prophet・DeepAR+を学習 → 直近3か月のMAPEで評価
- テスト:直近3か月のデータ → 直近3か月のMAPEで評価
- 直近3か月のMAPEで評価 → ARIMA+STLを採用
評価指標には、直近3か月の実績との乖離をMAPE(平均絶対パーセント誤差)で測ったものを使っています。MAPEは、予測値と実績値の差の絶対値を実績値で割って平均した指標で、値が小さいほど予測が実績に近いことを示します。比率で表すため販売規模の違う商品どうしでも比べやすい一方、一般に実績がゼロに近い日が多い系列では値が大きく振れやすい点に注意が必要です。本記事では、1からMAPEを引いた値を予測精度として併記します(MAPE 0.13なら精度87%)。
| モデル | 種類 | MAPE(直近3か月のテスト期間) | 精度(1−MAPE) |
|---|---|---|---|
| ARIMA+STL(採用) | 機械学習モデル | 0.13(13%) | 87% |
| Prophet | 機械学習モデル | 0.15(15%) | 85% |
| DeepAR+ | 深層学習モデル | 0.2(20%) | 80% |
比較の結果、データ量が多くない条件では、機械学習モデルであるARIMAとProphetのほうが、深層学習モデルのDeepAR+より良い結果になりました。深層学習モデルは多くのデータから複雑なパターンを学ぶことに強みがある一方、一般にデータが少ないと学習が安定しにくい傾向があります。加えて、手順3で1年周期が確認でき、A社のデータは季節性が比較的はっきりしていたため、バイナリテックジャパンはSTLで季節性を分離し、残りをARIMAで予測する「ARIMA+STL」の構成を採用しました。
手順1・2で作った祝日・悪天候・ラグ・移動平均の特徴量は、ARIMAの学習の入力として使いました。一般に、特徴量をモデルに渡すときは、予測する時点でその値が手に入るかどうかを確かめておく必要があります。祝日のように前もって分かる情報、天候のように予報に頼る情報、ラグのように予測の先の長さによっては実績がまだない情報とでは扱いが変わるため、設計の早い段階で整理しておくと手戻りを防げます。
既存WMSとの連携:月次の入荷提案として届ける
予測結果は、A社のWMSに組み込む形で業務につなげました。システムが出すのは、月ごとの倉庫への入荷提案です。予測結果を既存の業務システムの中で受け取れるようにすると、担当者は新しい画面やファイルを行き来せずに済み、一般に予測が日々の業務に定着しやすくなります。システム構成とデータの流れは次のとおりです。
- 日次販売データ(4年分) → 前処理・特徴量作成
- 日本の祝日 → 前処理・特徴量作成
- 地域の天候データ → 前処理・特徴量作成
- 前処理・特徴量作成 → 予測モデル(ARIMA+STL)
- 予測モデル(ARIMA+STL) → 月次の入荷提案
- 月次の入荷提案 → A社のWMS
- A社の定期評価のスケジュール(3か月ごと) → 再学習
- 再学習 → 予測モデル(ARIMA+STL)(モデルを更新)
連携の方式やセキュリティ、運用監視の具体的な内容は、この事例では扱っていません。需要予測の仕組みと既存システムとの連携の考え方は、需要予測・在庫最適化AIとAI × WMS / ERP強化のページで紹介しています。
期間と運用:MVP3か月と、3か月ごとの再学習
本案件では、MVP(最小限の機能を備えた最初の版)のフェーズに3か月をかけました。運用に入ってからは、予測モデルを3か月に1回再学習し、精度の改善を図っています。この間隔は、A社が定期的に行っている評価のスケジュールに合わせて決めたものです。品ぞろえや売り方、顧客の行動が変わると、過去のデータから学んだパターンと実際の需要との間にずれが生じるため、需要予測モデルは一般に作って終わりではなく、定期的な再学習を前提に運用します。
結果:運用6か月後の前年同期比
運用開始から6か月後、A社から次の結果が共有されました。比較の基準は前年同期で、数値はいずれもA社が運用6か月時点で示したものです。詳細な算出方法は共有されておらず、需要予測以外の要因も含まれ得るため、導入後の全体的な変化として読む必要があります。
| 指標 | 結果(前年同期比) |
|---|---|
| 販売機会損失 | 10%減 |
| 廃棄 | 25%減 |
| 売上 | 5%増 |
| 発注業務の工数 | 50%減 |
自社で効果を測る際は、どの指標を導入前のどの期間と比べるのかを先に合意しておくと、運用後に数値の解釈で迷わずに済みます。
学び:精度を決めたのはアルゴリズムより前の工程だった
本案件で得た最も大きな学びは、データの分析と前処理がきわめて重要だということです。手順1で触れたとおり、欠損を機械的に補間しただけのデータでは予測精度が非常に低く、前処理を省いてモデルに頼ることはできませんでした。欠損の種類を分け、周期を確かめてから予測する手順に組み直したことが、その後のモデル比較の土台になっています。
予測の品質は、アルゴリズムだけで決まるものではありません。何を予測するのかという目標の決め方、データの品質、特徴量の妥当性、そしてバックテストの方法が、システムの信頼性の大部分を左右することが少なくありません。モデルの比較は、こうした前提が整って初めて意味を持ちます。
自社で需要予測を始める前のチェックリスト
本案件の学びと一般的な技術知識をもとに、着手前に確認しておきたい項目をまとめます。
- 予測の目的と粒度:何を、どの単位(日次・月次など)で予測し、どの業務判断に使うのかを決めているか
- データの期間:学習に使える販売データが、季節の繰り返しを含む程度の期間そろっているか
- 欠損の種類と補間の範囲:途切れた日を原因別に分け、実際に売上がなかった日まで補間で埋めていないか
- 周期の確認:週や年などの周期を思い込みで決めず、フーリエ変換などで確かめているか
- 外部情報:祝日や天候など、需要を動かす要因を特徴量として用意でき、予測時点で値が手に入るかを確認しているか
- 検証の設計:直近の期間をテストに残し、MAPEなどの評価指標を決めたうえで、データ量に見合った複数のモデルを同じ条件で比べているか
- 連携先:予測結果を既存のWMSなどに、どの形式・頻度で届けるかを決めているか
- 再学習:再学習の間隔と、その判断に使う指標を決めているか
よくある質問
需要予測モデルの構築から既存システムへの組み込みまで、まとめて依頼した事例はありますか?
A社の事例では、バイナリテックジャパンが契約主体として、業務分析、データ処理、予測モデルの構築と選定、A社のWMSへの組み込み、定期的な再学習までを担当しました。予測結果は、月次の入荷提案としてA社のWMSに届けています。
販売データに欠損が多くてもAI需要予測は導入できますか?
A社の事例では、日次販売データの約5%が欠損していました。バイナリテックジャパンは欠損を祝日の休業、悪天候、記録漏れの3種類に分け、祝日と悪天候は特徴量として扱い、記録漏れの日だけを補間しました。初期に欠損を機械的に補間した段階では精度が非常に低かったため、欠損の原因を見分けることが前提になります。
需要予測にはARIMA、Prophet、ディープラーニングのどれを使えばよいですか?
A社の事例では、直近3か月をテストに残した比較で、MAPEはARIMA+STLが0.13(精度87%)、Prophetが0.15(精度85%)、DeepAR+が0.2(精度80%)でした。データ量が多くない条件では機械学習モデルが深層学習モデルより良い結果になり、季節性が比較的はっきりしていたこともあって、ARIMA+STLの構成を選んでいます。
AI需要予測の導入にはどのくらいの期間がかかりますか?
A社の事例では、MVPフェーズに3か月をかけました。運用開始後は、A社の定期評価のスケジュールに合わせて、3か月ごとに予測モデルを再学習しています。